

Anthropic'ten İki Yeni Model: Claude Fable 5.1 ve Mythos 5.1 Karşılaştırması

1 Eylül 2026'da Anthropic, Claude Fable 5.1 ve Claude Mythos 5.1 modellerini duyurdu. Bu lansmanla ilgili en çarpıcı şey, teknik bir sıçramadan ziyade bir dağıtım tercihi olmasıdır: Her iki model de aynı temel modeli çalıştırır ve aralarındaki tek fark, uygulanan güvenlik katmanının ne kadar sıkı ayarlandığıdır. Fable 5.1 genel kullanıma açık sürümdür; Mythos 5.1 ise yalnızca denetlenmiş siber güvenlik ve yaşam bilimleri kuruluşlarına açık kısıtlı programlar aracılığıyla sunulmaktadır.
Bu ayrım, kurumsal yapay zeka tartışmalarının uzun süredir örtük bıraktığı bir gerçeği gün yüzüne çıkarıyor: Bir modelin ölçülen yeteneği ile kullanıcıya fiilen ulaşan yetenek aynı şey değildir. Onları ayıran şey model mimarisi değil, güvenlik katmanı müdahaleleridir.
Aynı model, iki farklı erişim kademesi
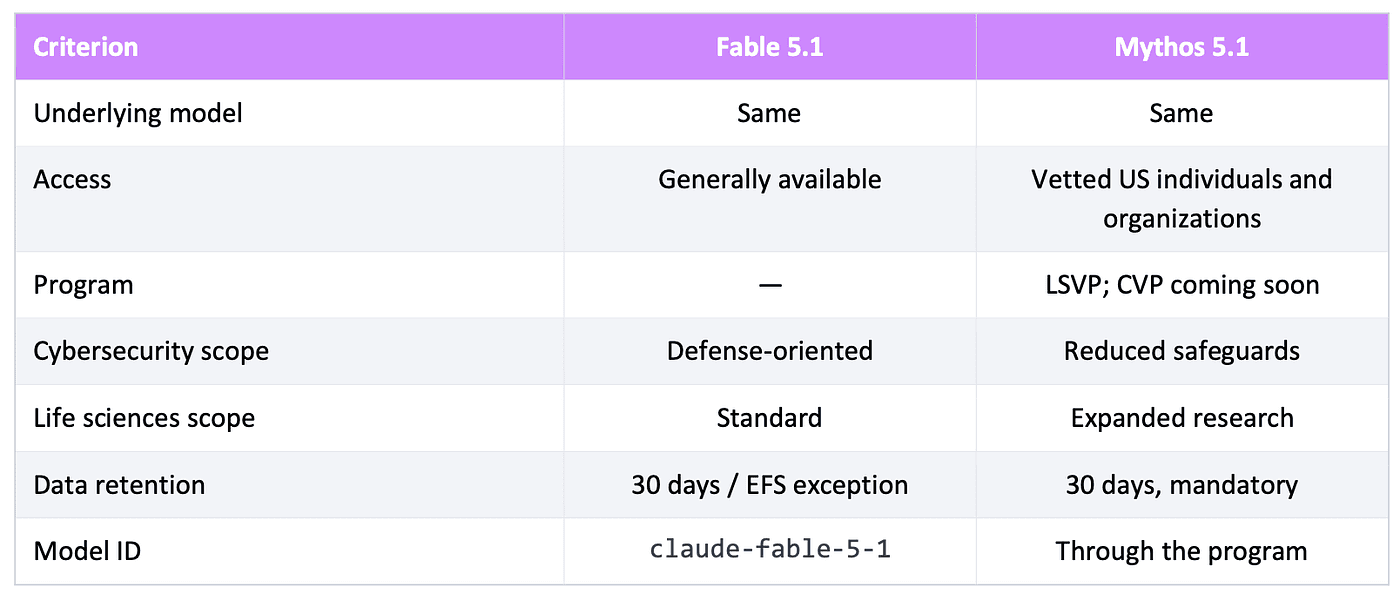
Tablo 1: Fable 5.1 ile Mythos 5.1 arasındaki fark model ağırlıklarında değil, güvenlik katmanında ve erişim rejimindedir.
Fable 5.1'de sızma testi, istismar üretimi ve ikili tabanlı güvenlik açığı tarama gibi talepler Opus modellerine yönlendirilir. Model, savunma amaçlı çalışmalarda yazılım açıklarını tespit edebilir ancak ofansif senaryolar güvenlik katmanı tarafından engellenir.
Güvenlik katmanının ölçülebilir maliyeti: 5.1 puan
Kurumsal karar vericiler için bu lansmandaki en önemli veri noktası bir yetenek sıçraması değil, aradaki farkın ölçümüdür.
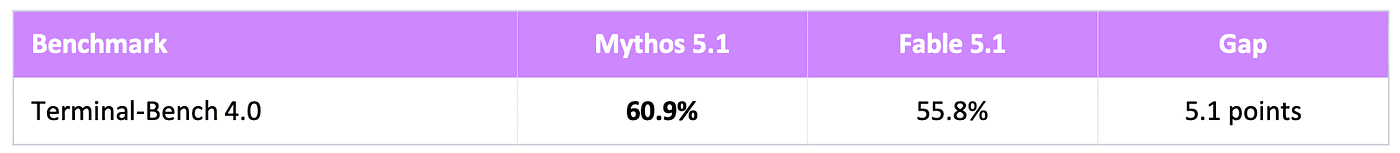
Tablo 2: Aynı temel modelin iki farklı güvenlik katmanı altındaki performansı.
Aynı model parametreleri, aynı kıyaslama testi, 5.1 puanlık bir fark. Bu farkı açıklayan tek değişken, güvenlik katmanı müdahalelerinin maliyetidir. Sektörün uzun süredir sezgisel olarak bildiği bir durum, ilk kez bizzat sağlayıcı tarafından yayınlanan rakamlarla ölçülmüş oldu.
Pratik terimlerle ifade etmek gerekirse: Bir modelin duyurulan kıyaslama skoru, size ulaşan sürümün skoru olmayabilir. Model değerlendirmesi artık yalnızca "hangi model" sorusunu değil, aynı zamanda "hangi kademe" sorusunu da kapsamalıdır. Kendi görev setiniz üzerinde yapılan bir ölçüm, sağlayıcının en iyi rakamından sistematik olarak farklı olacaktır ve bu fark tesadüfi değildir.
Bir uyarı: Anthropic, iki modeli yalnızca bu kıyaslama testinde ayrı ayrı raporladı. Diğer kıyaslama testleri için ayrıştırılmış bir Mythos rakamı yayınlanmadı, bu nedenle 5.1 puanlık farkın genel olarak geçerli olduğu varsayılamaz. Anthropic de yeni güvenlik önlemleriyle bu farkın daralmasını bekliyor.
Mythos 5.1'e kimler erişebilir?
Anthropic, Mythos 5.1'e erişimi iki doğrulama programı ile sınırlandırmaktadır. Siber Doğrulama Programı (CVP), savunma odaklı güvenlik çalışmaları yürüten kuruluşlara daha esnek siber güvenlik önlemleriyle erişim sağlar; Mythos sınıfı modeller yakın gelecekte programa eklenecektir. Yaşam Bilimleri Doğrulama Programı (LSVP), modelin araştırma yeteneklerini yaşam bilimleri profesyonellerine açmayı amaçlamaktadır; ilk katılımcılar kaydedilmiştir ancak genel kayıtlar henüz açık değildir. LSVP, ABD hükümetiyle ortaklaşa yürütülmektedir ve erişim şu anda ABD merkezli kuruluşlarla sınırlıdır.
Erişimin bir bedeli vardır: Mythos'u kullanmak, güvenlik izlemesi için 30 günlük veri saklama politikasını kabul etmeyi gerektirir. Aynı gereksinim Fable 5.1 için de geçerlidir; fark, Fable tarafında sunulan sıfır veri saklama istisnasındadır. Sıfır veri saklama gereksinimi olan kuruluşlar için bu durum satın alma sürecinde doğrudan bir engel oluşturabilir.
Kısıtlamanın gerekçesi sistem kartında açıklanmıştır. Anthropic, kimyasal ve biyolojik yetenekler için Mythos 5.1'i CB-1 olarak değerlendirmektedir; bu da modelin, kıt uzmanlığın yerine geçtiği nokta olarak tanımlanan CB-2 eşiğinin altında kaldığı anlamına gelir. Siber tarafta ise model, güvenlik önlemleri kapalıyken ölçüldüğünde daha düşük risk kademesinde kalmasına rağmen, bugüne kadar piyasaya sürdüğü en güçlü siber yeteneklere sahip model olarak konumlandırılmaktadır.
Erişim rejiminin ne kadar değişken olabileceğine dair bir örnek de mevcut: Fable 5 ve Mythos 5'e erişim, bir ihracat kontrolü yönergesi uyarınca 12 Haziran 2026'da askıya alınmış; Mythos 5 yalnızca 26 Haziran'da bir grup ABD'li kuruluş için yeniden açılmış ve Fable 5 ise küresel olarak 1 Temmuz'da geri dönmüştür. Bu, erişimin ticari bir paket değil, mevzuat onayına bağlı bir statü olduğu anlamına gelir.
Project Glasswing: Kısıtlı erişimin bugüne kadar ürettikleri
Mythos'un kısıtlı erişim modelinin nasıl çalıştığına dair en somut örnek Project Glasswing'dir. Girişim on iki ortak kuruluşla başlatıldı: Amazon Web Services, Anthropic, Apple, Broadcom, Cisco, CrowdStrike, Google, JPMorganChase, Linux Foundation, Microsoft, NVIDIA ve Palo Alto Networks. Anthropic o zamandan beri erişimi 40'tan fazla ek kuruluşa genişleterek toplam katılımcı sayısını yaklaşık 50'ye çıkardı.
22 Mayıs 2026 itibarıyla bu katılımcılar, sistem açısından kritik öneme sahip yazılımlarda on binden fazla yüksek veya kritik önem derecesine sahip güvenlik açığını tespit etmek için Claude Mythos Preview'u kullanmışlardı. Bu bulgulardan 1.726'sı yapılan takip analizlerinde doğrulandı.
Bu rakam, kısıtlı erişim modelinin mantığını açıklamaktadır. Bir güvenlik açığını bulmak ile onu istismar etmek arasındaki teknik mesafe, aralarındaki politika mesafesinden çok daha kısadır. Anthropic bu iki kullanımı model düzeyinde ayıramadığı için erişim düzeyinde ayırıyor: Yetenek aynı kalıyor, değişen şey ise bunu kimlerin kullanabileceği oluyor.
Kurumsal alıcı için buradaki soru nettir: İhtiyacınız olan yetenek, satın aldığınız kademenin içinde mi? Bu, model seçilmeden önce yanıtlanması gereken bir tedarik sorusu haline geliyor.
Performans: Terminal-Bench-Science üzerinde iki kat artış
Anthropic'in yayınladığı kıyaslama sonuçlarında en net ilerleme bilimsel görevlerde görülüyor. Terminal-Bench-Science 0.1'de Fable 5.1 %52,6 puan alırken, Fable 5 %24,7 ve Opus 5 %29,0 seviyesinde kalıyor. Bu, aynı ailedeki bir önceki sürüme göre iki kattan fazla bir artış anlamına geliyor.
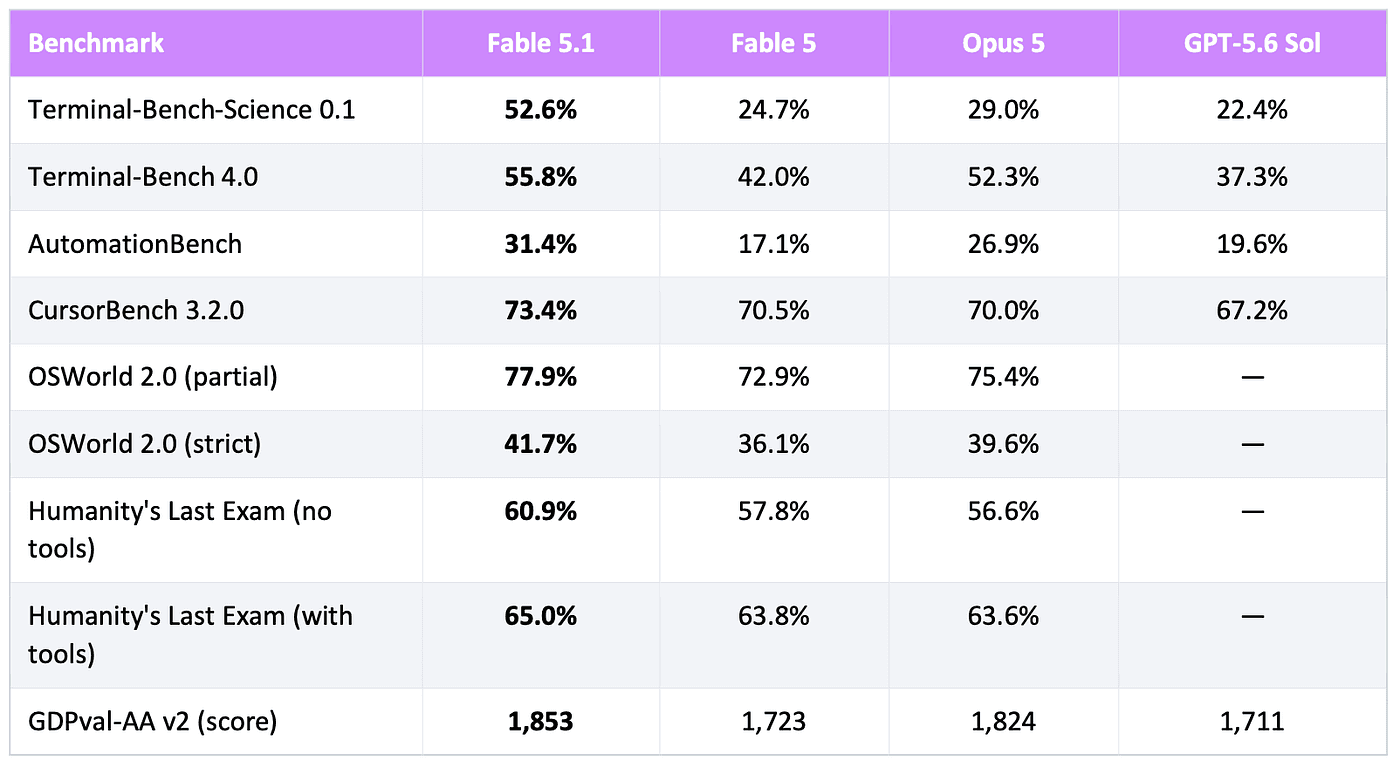
Tablo 3: Anthropic tarafından bildirilen kıyaslama sonuçları. Standart hata model başına yaklaşık 3,5-4,5 puandır. OSWorld 2.0 veya Humanity’s Last Exam için herhangi bir rakip skoru yayınlanmamıştır.
AutomationBench'teki iki kata yakın artış, saf muhakeme kıyaslama testlerindeki mütevazı kazanımlardan daha anlamlıdır. Bu test, çok adımlı otomasyon görevlerini ölçer ve kurumsal otonom (agentic) iş akışlarının fiilen başarısız olduğu yere, yani uzun zincirler boyunca bir görevi tamamlayabilme yeteneğine daha yakındır. Buna karşılık, Humanity’s Last Exam gibi yoğun bilgi gerektiren testlerdeki üç puanlık fark hata payı içinde kalmaktadır.
Küçük bir uyarı: Bu skorlar sağlayıcı tarafından bildirilmiştir. Birbirine yakın sonuçları gürültüden ayırt etmek için bağımsız değerlendirmeleri beklemek gerekir.
Asıl değişiklik fiyatlandırmada: Önbellek okumaları
Temel belirteç (token) fiyatları değişmedi. Değişen kalem önbellek okuma fiyatı oldu: Milyon belirteç başına 1,00 USD'den 0,25 USD'ye düşerek %75'lik bir indirim yapıldı.
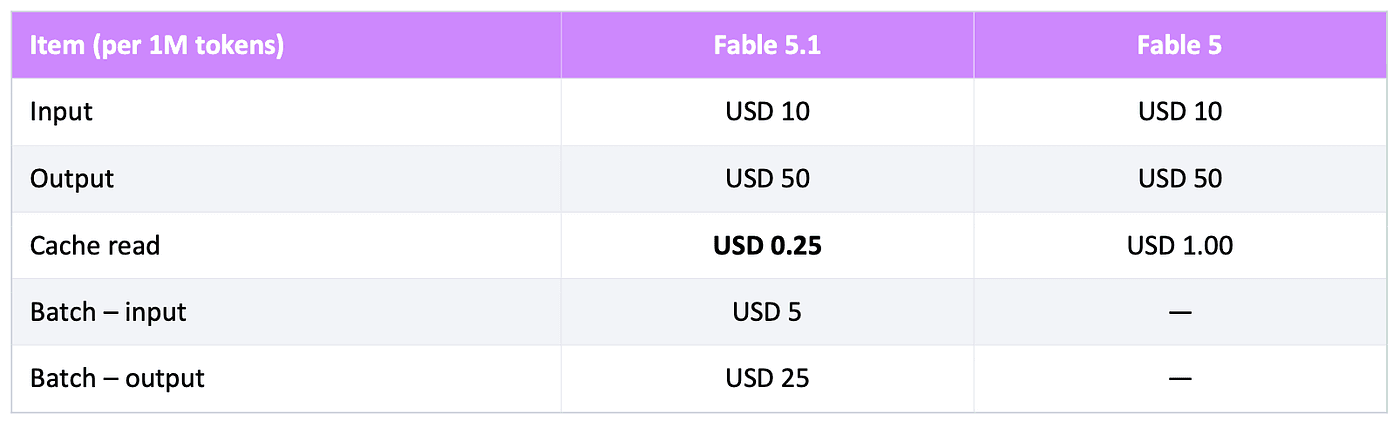
Tablo 4: Fable 5.1 ile Fable 5 arasındaki fiyat karşılaştırması. Fable 5.1'deki önbellek yazma ücretleri 5 dakikalık depolama için 12,50 USD ve 1 saatlik depolama için 20 USD'dir.
Anthropic'e göre bu değişiklik, tipik iş yüklerinde yaklaşık %25, yoğun bağlamlı otonom iş akışlarında ise %45'e varan bir maliyet düşüşü sağlıyor. Bu dağılım tesadüfi değildir: Uzun süre çalışan otonom yapılar, her adımda aynı sistem yönlendirmesini, aynı belge setini ve aynı araç tanımlarını tekrar okur. Bu mimaride baskın maliyet kalemi girdi belirteç fiyatı değil, önbellek okumalarıdır.
Kurumsal planlama için sonuç şudur: Maliyet avantajı, kısa ve tek seferlik çağrılarda değil, uzun bağlamlı, tekrarlayan otonom iş akışlarında kendini gösterir. Fiyat karşılaştırması yapan ekipler, liste belirteç fiyatına değil, kendi önbellek isabet oranlarına (cache hit rate) bakmalıdır.
Güvenlik Önlemleri
Güvenlik katmanlarındaki gerçek iyileşme ne kadar engellediklerinde değil, hassasiyetlerindedir. Yanlış pozitif, bir güvenlik filtresinin iyi niyetli bir talebi riskli bir talep olarak algılayıp reddetmesidir. Bir güvenlik katmanı gelen her talebi "bu zararlı mı?" diye sorarak sınıflandırır ve iki tür hata yapabilir: Zararsız bir talebi engellemek (yanlış pozitif) veya zararlı bir talebe izin vermek (yanlış negatif). Kendi ağını incelerken log analizi talebi reddedilen bir güvenlik mühendisi veya aşıların nasıl çalıştığına dair sorusu yanıtsız kalan bir öğretmen, ilk türden hatalara örnektir.
İki hata türü birbiriyle bağlantılıdır. Filtreyi sıkılaştırdığınızda zararlı taleplerin gözden kaçma olasılığı azalır ancak iyi niyetli olanların engellenme olasılığı artar; gevşettiğinizde ise tam tersi olur. Bu nedenle bir güvenlik katmanını "daha az engelleyici" hale getirmek kolaydır; eşiği düşürmeniz yeterlidir. Zor olan kısım, koruma seviyesini düşürmeden yanlış pozitifleri azaltmaktır; yani filtreyi daha izin verici değil, daha hassas hale getirmektir. Anthropic'in bildirdiği iyileşme bu ikinci türdendir.
Anthropic'e göre, siber güvenlik önlemleri bir önceki sürüme göre %60 daha az yanlış pozitif üretirken, biyoloji önlemleri temel eğitim ve tıbbi sorularla ilgili iyi niyetli taleplerde %85 daha az devreye giriyor.
Bu durum, kurumsal kullanımda rutin olarak göz ardı edilen bir pürüz kaynağını hedef alıyor. Haklı bir talebi gereksiz yere reddeden bir model, kullanıcının bakış açısından yetersiz bir modelden farksızdır ve benimsenme sürecini aynı derecede yavaşlatır.
Hizalama (alignment) konusunda Anthropic, modelin test ortamı dışındaki kaynaklara ulaşmaya çalışma eğiliminin belirgin şekilde azaldığını, açık kısıtlamaları görmezden gelme ve ödül kodlama (reward hacking) eğilimlerinin düştüğünü ve harici bir komut enjeksiyonu (prompt injection) değerlendirmesinde bugüne kadarki en sağlam model olduğunu bildiriyor.
Sonuç
Fable 5.1'in gerçek hikayesi model kalitesi değil, modelin nasıl paketlendiğidir. Aynı ağırlıkların iki farklı güvenlik katmanı ve iki farklı erişim rejimi altında sunulması ve aralarındaki farkın artık 5.1 puan olarak ölçülebilmesi, önümüzdeki dönemde "hangi model" sorusunun yerini "hangi kademe ve hangi doğrulama programı" sorusuna bırakacağını gösteriyor.
Project Glasswing'in on binden fazla kritik güvenlik açığı tespit etmesi, kısıtlı kademenin gerçek bir yetenek farkı taşıdığını gösteriyor. Haziran 2026'da ihracat kontrolleri kapsamında Fable 5 ve Mythos 5'e erişimin askıya alınması ve Temmuz başında yeniden açılması, bu kademenin ticari bir durumdan ziyade yasal bir statü olduğunu gösteriyor. Yapay zeka tedariği giderek bir satın alma kararından ziyade bir yetkilendirme sürecine benziyor.
Kurumsal ekipler için pratik çıkarımlar üç noktada toplanıyor. İlk olarak, maliyet değerlendirmenizi liste belirteç fiyatlarına göre değil, kendi önbellek isabet oranınıza göre yapın; %75'lik indirim yalnızca aynı bağlamı tekrar tekrar okuyan iş akışlarında kazanç sağlar. İkinci olarak, bir pilot çalışma başlatmadan önce kullanım senaryonuzun genel kullanıma açık kademeye dahil olup olmadığını doğrulayın; savunma amaçlı güvenlik veya yaşam bilimleri alanında çalışıyorsanız doğrulama programı takvimi, satın alma planınızın bir parçasıdır. Üçüncü olarak, kendi görev setinizdeki kıyaslama sıçramasını yeniden ölçün; hem standart hata hem de kademeler arasındaki 5.1 puanlık fark, sağlayıcı skorlarının olduğu gibi kabul edilemeyeceğini gösteriyor.
Model dünyasındaki rekabet artık yalnızca yetenek eğrisi boyunca değil, aynı zamanda bu yeteneğin kime ve hangi şartlarda açıldığı düzleminde de ilerliyor.


